Al final de la primera parte prometí la búsqueda de rutas: «¿cómo llego de A a B?», con dos transbordos como mucho y un tramo corto a pie entre paradas cuando eso sale mejor que esperar. En el servidor ya existía, «escrita, lo has adivinado, como otra consulta recursiva», y la app todavía no la llamaba.
Este otoño la app empezó a llamarla. Desde hoy, la búsqueda de rutas ya no se ejecuta en SQL. Esta es la historia de las seis semanas entre medias, y va menos de autobuses que de lo que pasa cuando una consulta que funciona en un portátil se encuentra con una base de datos que vive en otra parte.
Andar también es una línea
La red de la primera parte son paradas y aristas: «la A va de C/ Mayor a Petanca en 1 minuto 40». Para planificar un viaje también hay que andar: desde donde estás hasta una parada, de una parada a otra para cambiar de línea, y de la última parada hasta donde vas.
El primero y el último empiezan o terminan en un sitio que no es una parada, así que salen de un router a pie. El del medio es un truco. Un pequeño script SQL recorre cada par de paradas a menos de 500 metros que todavía no tiene arista, y le añade una en una línea llamada walk():
SELECT a, b, 'walk()' AS line,
       PRINTF("%g", ROUND(distance * 3600 / 3)) || 's' AS duration -- 3 km/h walking speed with "obstacles" (e.g. traffic lights)
FROM ( … the distance between two stops, as great-circle maths in SQL … )
Tres kilómetros por hora parece lento hasta que te acuerdas de los semáforos, las rotondas y el sol de agosto. A partir de ahí, ir a pie es una arista más con su duración, y el router no necesita saber la diferencia. En la tabla hay más aristas a pie que de autobús: unas seiscientas contra cuatrocientas, en septiembre.
La consulta
La búsqueda de rutas es prima de la consulta de hora de llegada de la primera parte, pero con ambiciones. Empieza en una parada, sigue aristas y recuerda por dónde ha pasado. Aquí está un poco recortada, pero es la versión que funcionó hasta hoy:
WITH RECURSIVE dfs(station_id, path, path_lines, current_line, depth, line_changed, stations_on_current_line) AS (
  SELECT e.`from`, CAST(e.`from` AS TEXT), CAST(e.`line` AS TEXT), e.`line`, 0, 0, 1
  FROM route_edges e WHERE e.`from` = {:from}
  UNION ALL
  SELECT e.`to`,
         dfs.path || CASE WHEN e.`line` != dfs.current_line THEN ';switch()' ELSE '' END || ';' || e.`to`,
         …,
         e.`line`, dfs.depth + 1,
         CASE WHEN e.`line` = dfs.current_line THEN dfs.line_changed ELSE dfs.line_changed + 1 END,
         CASE WHEN e.`line` = dfs.current_line THEN dfs.stations_on_current_line + 1 ELSE 1 END
  FROM dfs JOIN route_edges e ON e.`from` = dfs.station_id
  WHERE dfs.depth < {:depth}
    AND instr(dfs.path, e.`to`) = 0
    AND (e.`line` = dfs.current_line
         OR (dfs.line_changed < 2 AND dfs.stations_on_current_line >= 2))
)
SELECT station_id, path_lines, depth, path FROM dfs
WHERE station_id = {:to} AND stations_on_current_line >= 2
ORDER BY depth, <number of lines> LIMIT {:limit};
Cada fila es un camino a medio hacer: las paradas hasta ahora como texto, las líneas usadas, cuántas veces ha cambiado. Todas las reglas están en el WHERE:
- No pasar nunca dos veces por la misma parada.
instr(path, stop) = 0busca una subcadena en el camino. Es tosco: en cuanto un camino ha pasado porpanorama-2, dapanoramapor visitada también. Casi siempre funciona. - Dos transbordos como mucho.
- Recorrer al menos dos paradas antes de cambiar. Sin esta regla, la búsqueda se sube tan contenta a un autobús para una sola parada y cambia en la siguiente.
El router tampoco sabe a qué parada vas a ir andando. Coge las tres paradas más cercanas a donde estás y las tres más cercanas a donde vas: nueve pares. Para cada par pide caminos de hasta 5 aristas de profundidad. Si encuentra menos de cuatro rutas, prueba con 10, luego con 15, y así hasta 50.
Los marcadores {:from} son sintaxis de PocketBase, y también lo es {{route_edges}}, que arriba he escrito como route_edges a secas. En nuestro servidor los rellena el propio PocketBase. En el Worker hacen lo mismo unas pocas líneas de código, así que nuestros ficheros de consultas funcionan en los dos sitios. Estaba bastante orgulloso de eso. La búsqueda de rutas, por cierto, nunca se ejecutó en otro sitio que no fuera el Worker.
Funcionaba. Luego le apuntamos la app
La consulta apareció por primera vez en octubre de 2024, como un fichero que ejecutaba a mano, y tuvo endpoint en noviembre, en un commit llamado «navigation alpha». La app nunca la llamó.
En agosto nuestro desarrollador de Flutter la convirtió en un método de API como es debido, que parte de dos puntos del mapa en lugar de dos ids de parada. En octubre, la pantalla de navegación de la app, hecha durante el verano con datos simulados, se conectó a él, y las compilaciones de desarrollo empezaron a hacer preguntas reales, desde sitios reales, hacia destinos reales. Los problemas empezaron esa misma semana:
- Finales de octubre. La primera optimización: un camino tiene que recorrer al menos dos paradas antes de poder cambiar. Para las personas es una regla sensata, y recorta la búsqueda.
- Finales de noviembre. El método tuvo su ruta en la API de producción, y al día siguiente D1 se estaba quedando sin memoria. Cada búsqueda mandaba los nueve pares de paradas a la vez, y el arreglo fue mandarlos uno detrás de otro, con un comentario que dice lo que creíamos que pasaba: «buscar caminos SECUENCIALMENTE para evitar errores de falta de memoria en D1 por demasiadas consultas CTE recursivas concurrentes.»
- 1 de diciembre. Una teoría: era la propia recursión la que se comía la memoria, bajando hasta el fondo por una rama tras otra. Así que se escribió una versión de la consulta en anchura, bajo un comentario que dice «enfoque BFS con consultas iterativas en lugar de un CTE recursivo. Así se evita la explosión de memoria de la recursión profunda.» El mismo commit amplió la búsqueda a las cuatro paradas más cercanas en cada extremo, dieciséis pares, y limitó la profundidad a 30. Nada de eso cambió nada que pudiéramos ver.
D1 es SQLite en el lado de Cloudflare, y tiene límites que el portátil no tiene: una consulta tiene 30 segundos y mucha menos memoria que un portátil, aunque Cloudflare no dice exactamente cuánta. Nuestra consulta iba bien con una red pequeña y un viaje corto. De punta a punta de la ciudad, a diez aristas de profundidad, no.
Desde hoy: el grafo vive en el Worker
Así que hoy dejamos de preguntarle a SQL.
Las paradas y las aristas van ahora a una instantánea, un fichero protobuf en R2. La primera vez que un Worker la necesita, carga ese fichero en graphology, construye un mapa sencillo de qué parada lleva a cuál y lo guarda en memoria el resto de su vida. La búsqueda es un bucle con una pila: coges un camino, lo alargas por cada arista permitida y apilas el resultado. Las reglas son las mismas tres que en el SQL. D1 sigue ahí para las preguntas baratas, como «qué paradas hay cerca de este punto» y «cuándo pasa el próximo autobús», que responde en milisegundos.
Los nuevos logs de rendimiento dicen que una búsqueda tarda ahora 0,00 ms. He decidido creérmelo.
La lección que me llevo: SQL era la herramienta adecuada para «sumar un trozo de un vector» y la equivocada para «enumerar todas las formas de ir de aquí a allí». Mil aristas es una tabla diminuta, y una consulta que cabe en una pantalla es una consulta diminuta. El número de caminos no es ni lo uno ni lo otro.
Lo siguiente
- Un proceso nocturno que reconstruya la instantánea a partir de la base de datos, para que nadie tenga que acordarse.
- Los autobuses en un motor de rutas de verdad. Las indicaciones a pie ya salen de Valhalla, un motor de rutas que alojamos nosotros mismos. También sabe de transporte público, si le das un fichero GTFS: el formato estándar de horarios, que, que sepamos, nadie publica para Torrevieja.
- Lo medimos, con nueve meses de retraso. Reconstruimos desde git la red de septiembre de 2025 y repetimos la búsqueda en un D1 local, que informa del mismo contador de filas leídas por el que factura D1. Una consulta desde una parada, a cinco aristas de profundidad, leía una mediana de unas 5.800 filas. A diez aristas, unas 556.000, y 51,8 millones desde el centro. Una búsqueda de un usuario leía una mediana de unos 2,2 millones de filas y una media de unos 4,1 millones, y eso es una cota inferior. Los 5 millones de filas al día del plan gratuito dan para una o dos búsquedas. En el plan de pago, mil búsquedas al día habrían costado unos 99 $ al mes además de los 5 $. Por lo que sabemos, nadie llegó a pagarlo: ninguna versión publicada en las tiendas llevó la búsqueda antes de que se mudara. Los últimos tres días, con dieciséis pares de paradas en lugar de nueve, cada búsqueda salía unas 1,8 veces más cara.
- Nunca fue una búsqueda en profundidad. Un CTE recursivo en SQLite guarda sus filas pendientes en una cola salvo que le pongas un
ORDER BYa la parte recursiva, así que la nuestra fue en anchura desde el principio. Eso explica, casi con seguridad, la falta de memoria: una búsqueda en anchura tiene toda la frontera en memoria a la vez, y a diez aristas de la estación de autobuses eso son unos 650 MB, varias veces los 128 MB que recibe un isolate de Cloudflare, lo más parecido a un límite que Cloudflare documenta. Y la reescritura del 1 de diciembre nunca se ejecutó. Editaba una copia renderizada de la consulta que guardábamos para depurar, mientras que el Worker carga la plantilla. La búsqueda en memoria que sustituyó a las dos es, muy oportunamente, la primera búsqueda en profundidad de verdad de este post.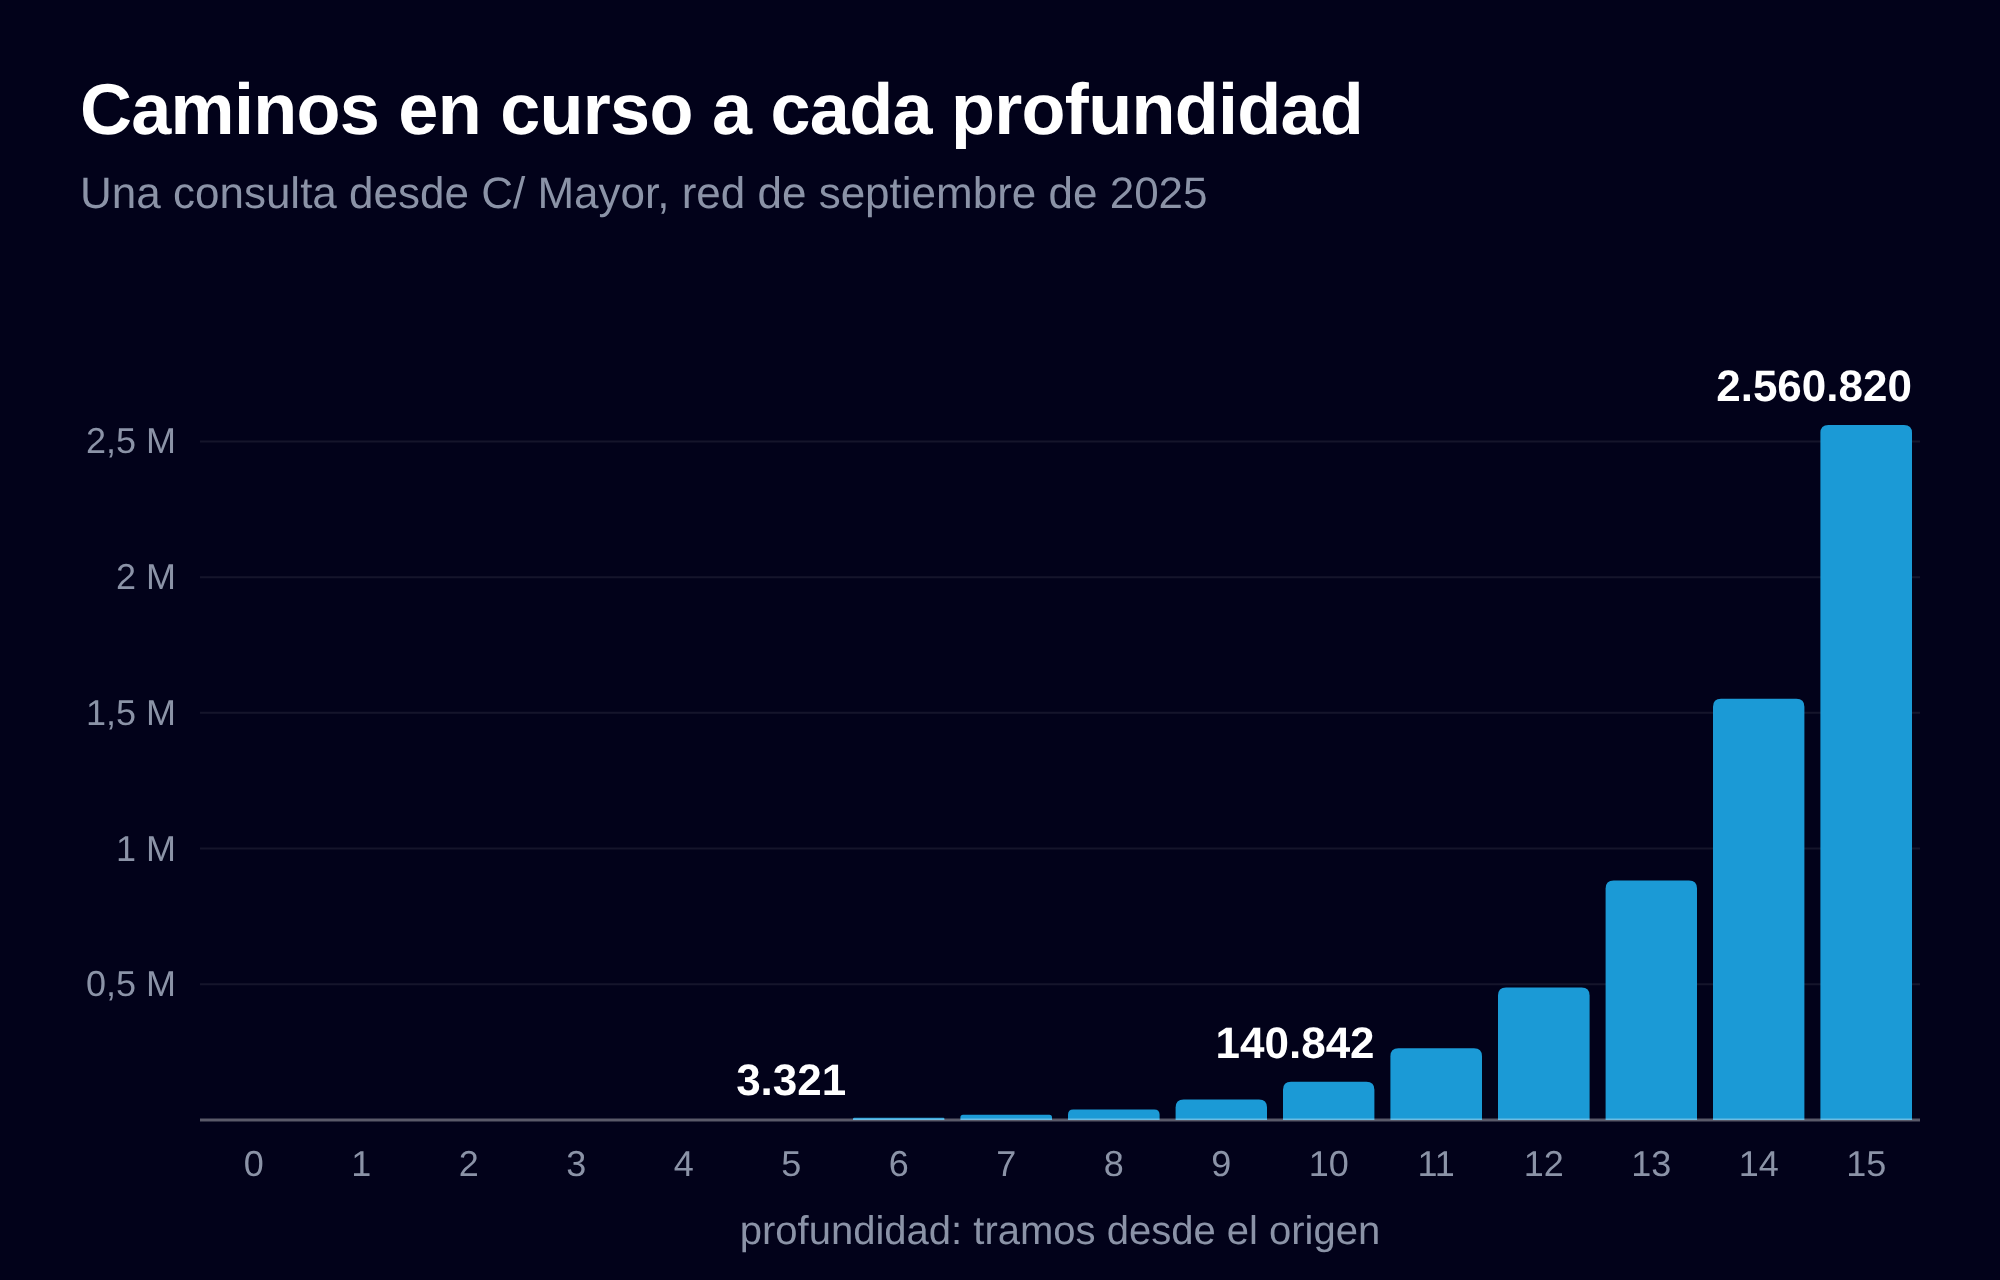
- La culpa fue de andar. Todas las aristas a pie están en la misma «línea»,
walk(), así que ir andando de parada en parada en parada nunca contaba como transbordo, y la regla de las dos paradas hacía que un transbordo a pie tuviera que dar al menos dos saltos andando. Dentro de la malla de aristas a pie, la búsqueda podía pasearse a sus anchas. Quitar la malla reduce una consulta a diez aristas en un factor mediano de 220. La tabla en sí nunca fue el problema: SQLite crea un índice temporal, así que cada consulta la lee entera solo dos veces. En agosto de 2026 andar pasó a ser un transbordo, como cambiar de autobús. - Los logs mentían. Al día siguiente la búsqueda en memoria se quedó atascada, así que le pusimos un timeout de tres segundos. Ese timeout no podía saltar nunca. Los Workers congelan el reloj mientras el código se ejecuta sin hacer E/S, como defensa contra ataques de temporización, así que
Date.now()yperformance.now()devuelven el mismo valor por mucho que dé vueltas el bucle. Cada «0,00 ms» de nuestros logs era ese reloj congelado. En agosto de 2026 una petición quemó 32,5 segundos de CPU antes de morir. Ahora se para tras un número fijo de pasos, compartido por toda la petición. - El proceso nocturno llegó dos días después y escribía
navigation-graph1.pb. El Worker leenavigation-graph.pb. Así que la reconstrucción nocturna no llegó a producción en ocho meses, hasta agosto de 2026. - Los autobuses sí se mudaron a Valhalla, con un feed GTFS que generamos nosotros, en agosto de 2026. Eso es la quinta parte de esta serie.
- ¿Y la consulta del vector que, según la primera parte, «cualquier base de datos responde en nada»? Resultó ser cerca del 80 % de todo lo que leía D1. La tabla que filtra no tenía ningún índice, así que cada sondeo de la app la recorría entera. De noche podía incluso decir que ya no quedaban autobuses: cogía las dieciséis salidas más cercanas antes de separarlas en pasadas y futuras, y a las once y media, en una línea con un autobús cada diez minutos, las dieciséis eran del pasado. Desde finales de septiembre de 2026, el panel de cada línea es un pequeño fichero precalculado en Cloudflare KV, que se reconstruye cada vez que cambia el horario, y una petición lee unas dos filas.
- Y luego la siguiente. Sin los paneles, la lista de consultas principales de Cloudflare tenía un nuevo líder: la búsqueda de paradas, con unos cuatro millones de filas al día. Ejecutaba una vista que une todas las paradas, líneas y aristas y las agrupa, reconstruida entera en cada pulsación de tecla. En segundo lugar, con 1,25 millones, iba la comprobación de frescura que el arreglo de los paneles acababa de añadir a cada petición de panel. En octubre la red visible pasó a ser un fichero más en KV, y la búsqueda, la parada más cercana y el mapa lo leen ahora en JavaScript a pelo. El SQL antiguo se queda en los tests, como la respuesta con la que el código nuevo tiene que coincidir fila a fila.
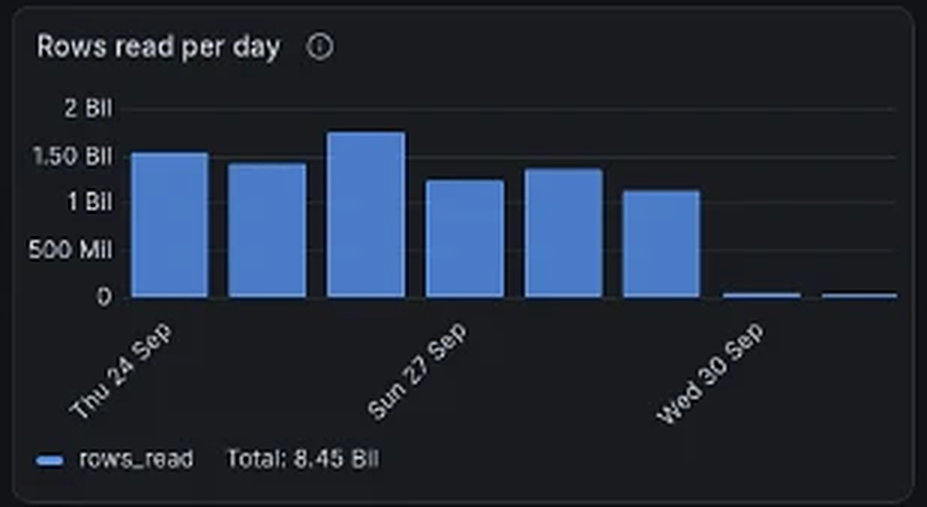
- Y un dashboard para no perderlo de vista. Nuestro Grafana lee ahora en directo, desde la API de analítica de Cloudflare, los números que hay detrás de la página de D1: filas leídas por consulta, por hora y por ejecución. Esta última no se mueve con el tráfico, solo cuando una consulta mejora o empeora. El dashboard también explicó por qué la consulta de la parada más cercana apenas aparecía en los rankings. Sus coordenadas se pegaban directamente en el texto SQL, con el mismo truco de plantillas del que tan orgulloso estaba más arriba, así que cada posición contaba como una consulta distinta. Y su primera semana ya muestra el arreglo de los paneles: