В конце первой части я пообещал поиск пути: «Как добраться из пункта А в пункт Б?» — максимум с двумя пересадками и коротким пешим переходом между остановками, если так быстрее, чем ждать. На сервере он уже был — «написано это, как ты уже догадался, ещё одним рекурсивным запросом», — а приложение его пока не вызывало.
Этой осенью приложение начало его вызывать. А с сегодняшнего дня поиск пути обходится без SQL. Это история о шести неделях посередине, и она не столько про автобусы, сколько про то, что бывает, когда запрос, который работает на ноутбуке, встречается с базой, которая живёт где-то в другом месте.
Ходьба — тоже маршрут
Сеть из первой части — это остановки и рёбра: «маршрут A едет от C/ Mayor до Petanca за минуту сорок». Но чтобы спланировать поездку, приходится ещё и ходить пешком: от того места, где ты сейчас, до остановки, от одной остановки до другой, чтобы сменить маршрут, и от последней остановки до того места, куда тебе надо.
Первый и последний начинаются или заканчиваются не на остановке, так что их считает пешеходный роутер. А вот средний — это фокус. Небольшой SQL-скрипт перебирает все пары остановок меньше чем в 500 метрах друг от друга, между которыми ещё нет ребра, и соединяет их ребром на маршруте под названием walk():
SELECT a, b, 'walk()' AS line,
       PRINTF("%g", ROUND(distance * 3600 / 3)) || 's' AS duration -- 3 km/h walking speed with "obstacles" (e.g. traffic lights)
FROM ( … the distance between two stops, as great-circle maths in SQL … )
Три километра в час — это вроде бы медленно, пока не вспомнишь про светофоры, кольца и августовское солнце. А дальше пеший переход — просто ещё одно ребро со своей длительностью, и поиску незачем отличать его от автобусного. Пеших рёбер в таблице больше, чем автобусных: на сентябрь около шестисот против четырёхсот.
Запрос
Поиск пути — это двоюродный брат запроса из первой части, который считал время прибытия, только с амбициями. Он начинает с одной остановки, идёт по рёбрам и запоминает, где уже побывал. Здесь он слегка урезан, но это та самая версия, которая работала до сегодняшнего дня:
WITH RECURSIVE dfs(station_id, path, path_lines, current_line, depth, line_changed, stations_on_current_line) AS (
  SELECT e.`from`, CAST(e.`from` AS TEXT), CAST(e.`line` AS TEXT), e.`line`, 0, 0, 1
  FROM route_edges e WHERE e.`from` = {:from}
  UNION ALL
  SELECT e.`to`,
         dfs.path || CASE WHEN e.`line` != dfs.current_line THEN ';switch()' ELSE '' END || ';' || e.`to`,
         …,
         e.`line`, dfs.depth + 1,
         CASE WHEN e.`line` = dfs.current_line THEN dfs.line_changed ELSE dfs.line_changed + 1 END,
         CASE WHEN e.`line` = dfs.current_line THEN dfs.stations_on_current_line + 1 ELSE 1 END
  FROM dfs JOIN route_edges e ON e.`from` = dfs.station_id
  WHERE dfs.depth < {:depth}
    AND instr(dfs.path, e.`to`) = 0
    AND (e.`line` = dfs.current_line
         OR (dfs.line_changed < 2 AND dfs.stations_on_current_line >= 2))
)
SELECT station_id, path_lines, depth, path FROM dfs
WHERE station_id = {:to} AND stations_on_current_line >= 2
ORDER BY depth, <number of lines> LIMIT {:limit};
Каждая строка — это недостроенный путь: список пройденных остановок в виде текста, задействованные маршруты и число пересадок. Все правила сидят в WHERE:
- Никогда не заезжать на одну остановку дважды.
instr(path, stop) = 0— это поиск подстроки в пути. Топорно: стоит пути проехатьpanorama-2, какpanoramaтоже считается пройденной. Но в основном работает. - Не больше двух пересадок.
- Перед пересадкой проехать хотя бы две остановки. Без этого правила поиск с радостью садится в автобус на одну остановку, чтобы на следующей пересесть.
Поиск не знает и того, до какой остановки ты пойдёшь пешком. Он берёт три ближайшие к тебе остановки и три ближайшие к тому месту, куда ты едешь: девять пар. Для каждой пары он запрашивает пути глубиной до 5 рёбер. Если набирается меньше четырёх вариантов, он пробует 10, потом 15 и так вплоть до 50.
Плейсхолдеры вроде {:from} — это синтаксис PocketBase, как и {{route_edges}}, который выше я для простоты написал обычным route_edges. На нашем сервере их подставляет сам PocketBase, а в Worker то же самое делают несколько строчек кода, так что наши файлы с запросами работают и там, и там. Я этим, признаться, гордился. Сам поиск пути, правда, так никогда и не запускался нигде, кроме Worker.
Всё работало. Потом мы натравили на него приложение
Впервые запрос появился в октябре 2024 года — как файл, который я запускал руками, — а в ноябре получил эндпоинт в коммите под названием «navigation alpha». Приложение его ни разу не вызвало.
В августе наш Flutter-разработчик превратил его в полноценный метод API, который начинает с двух точек на карте, а не с двух id остановок. В октябре к нему подключили экран навигации, который за лето собрали на моковых данных, и дев-сборки начали задавать настоящие вопросы — из настоящих мест в настоящие места. Проблемы начались на той же неделе:
- Конец октября. Первая оптимизация: прежде чем пересесть, путь должен проехать хотя бы две остановки. Для людей правило разумное, а поиск оно заметно сужает.
- Конец ноября. Метод получил маршрут в продовом API, и через день у D1 уже заканчивалась память. Каждый поиск отправлял все девять пар остановок разом. Починили это тем, что стали отправлять их по одной, а рядом оставили комментарий с нашей тогдашней версией происходящего: «искать пути ПОСЛЕДОВАТЕЛЬНО, чтобы не ловить от D1 ошибки нехватки памяти из-за слишком большого числа одновременных рекурсивных CTE-запросов».
- 1 декабря. Гипотеза: память съедает сама рекурсия, которая уходит вглубь по одной ветке за другой. Поэтому появилась версия запроса с поиском в ширину и комментарием сверху: «Подход BFS: итеративные запросы вместо рекурсивного CTE. Так мы избегаем взрывного роста памяти при глубокой рекурсии». Тот же коммит расширил поиск до четырёх ближайших остановок с каждого конца — шестнадцать пар — и ограничил глубину тридцатью. Ничего заметного всё это не изменило.
D1 — это SQLite на стороне Cloudflare, и ограничения там такие, каких у ноутбука нет: на запрос даётся 30 секунд, а памяти куда меньше, чем у ноутбука, — сколько именно, Cloudflare не говорит. На маленькой сети и для короткой поездки наш запрос чувствовал себя нормально. Через весь город на глубину в десять рёбер — уже нет.
С сегодняшнего дня граф живёт в Worker
Так что сегодня мы перестали спрашивать у SQL.
Остановки и рёбра теперь складываются в снапшот — protobuf-файл в R2. Когда файл впервые нужен Worker, тот загружает его в graphology, строит из него простую табличку — какая остановка куда ведёт — и держит её в памяти до конца своей жизни. Сам поиск — это цикл со стеком: берёшь путь, продлеваешь его по каждому разрешённому ребру и кладёшь то, что вышло, обратно на стек. Правила — те же три, что были в SQL. А D1 по-прежнему отвечает на дешёвые вопросы вроде «какие остановки рядом с этой точкой» и «когда следующий автобус», и отвечает за миллисекунды.
Судя по новым логам производительности, поиск теперь занимает 0,00 мс. Я решил им верить.
Урок, который я из этого выношу: SQL был правильным инструментом, чтобы «сложить срез вектора», и неправильным, чтобы «перечислить все способы добраться отсюда туда». Тысяча рёбер — крошечная таблица, а запрос, который помещается на один экран, — крошечный запрос. А вот число путей крошечным не назовёшь.
Что дальше
- Ночная джоба, которая пересобирает снапшот из базы, чтобы никому не приходилось об этом помнить.
- Автобусы в настоящем роутинг-движке. Пешеходную навигацию нам уже даёт Valhalla — роутинг-движок, который мы хостим сами. Общественный транспорт он тоже умеет, если скормить ему GTFS-файл: стандартный формат расписаний, который для Торревьехи, насколько мы знаем, никто не публикует.
- Замерили — с опозданием на девять месяцев. Мы восстановили из git сеть образца сентября 2025 года и прогнали поиск на локальной копии D1, которая отдаёт тот же счётчик прочитанных строк, по которому D1 выставляет счёт. Медианный запрос от одной остановки на глубину в пять рёбер читал около 5 800 строк. На глубину в десять рёбер — около 556 000, а от центра города — 51,8 миллиона. Медианный пользовательский поиск читал около 2,2 миллиона строк, средний — около 4,1 миллиона, и это ещё оценка снизу. Бесплатных 5 миллионов строк в день хватает на один-два поиска. На платном тарифе тысяча поисков в день обошлась бы примерно в $99 в месяц сверх базовых $5. Насколько мы можем судить, этих денег так никто и не заплатил: ни один релиз в сторах не вышел с этим поиском до того, как он переехал. Последние три дня, с шестнадцатью парами остановок вместо девяти, каждый поиск обходился примерно в 1,8 раза дороже.
- Поиском в глубину он не был никогда. Рекурсивный CTE в SQLite складывает необработанные строки в очередь, если только не дать рекурсивной части
ORDER BY, так что наш всё это время искал в ширину. Почти наверняка отсюда и нехватка памяти: поиск в ширину держит весь фронт обхода сразу, а в десяти рёбрах от автовокзала это около 650 МБ — в несколько раз больше тех 128 МБ, что достаются изоляту Cloudflare. Это самое близкое к лимиту, что Cloudflare вообще документирует. А переписанная 1 декабря версия так ни разу и не запустилась. Правка ушла в отрендеренную копию запроса, которую мы держали для отладки, а Worker загружает шаблон. Поиск в памяти, который пришёл на смену им обоим, — первый настоящий поиск в глубину в этом посте, что вполне символично.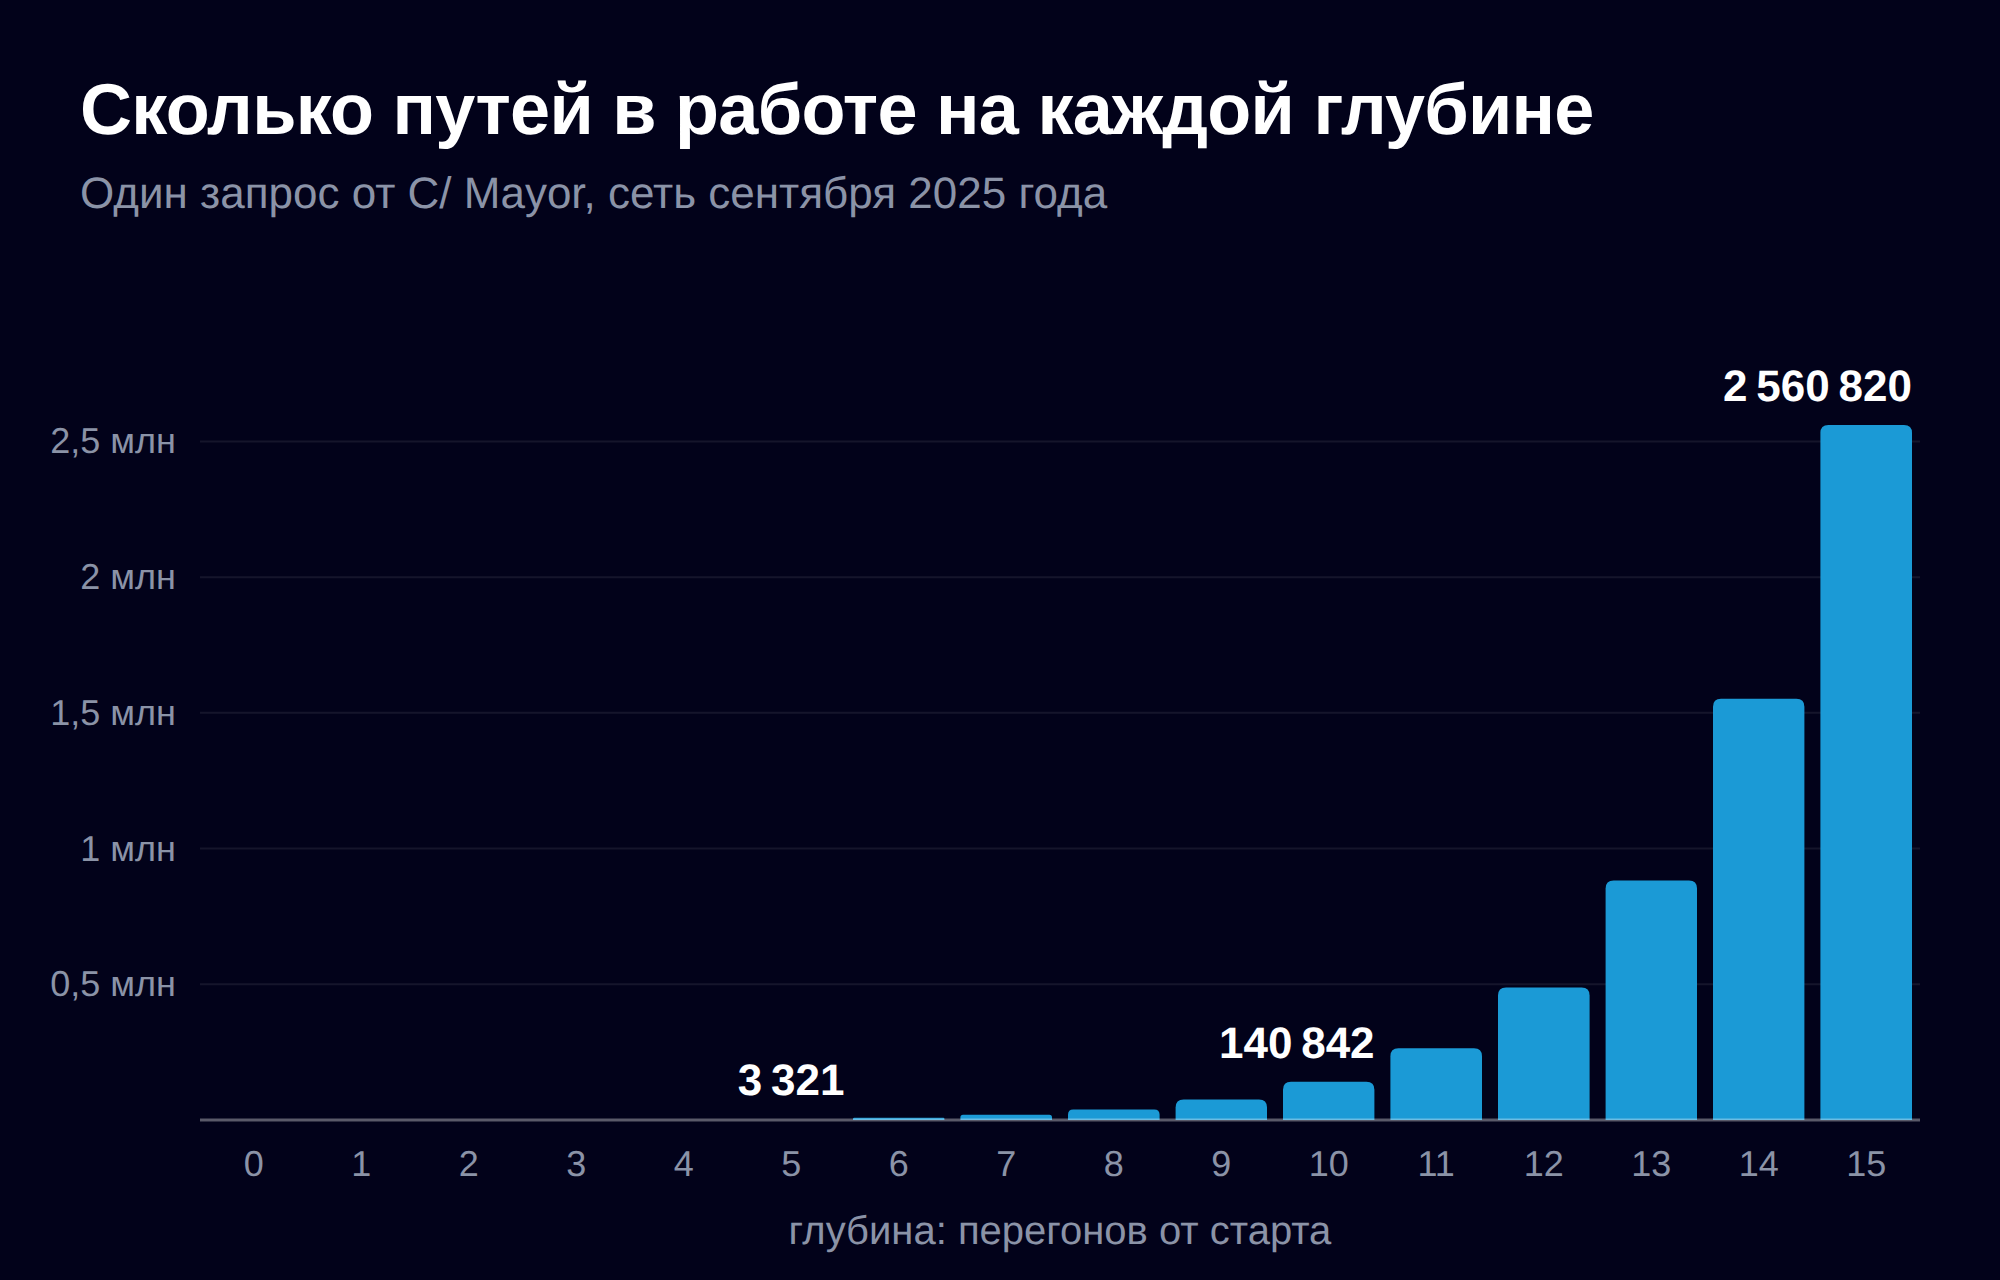
- Виноваты пешие переходы. Все пешие рёбра сидят на одном и том же «маршруте»
walk(), так что ходьба от остановки к остановке и дальше пересадкой не считалась, а из-за правила двух остановок пешая пересадка требовала как минимум двух пеших шагов. Внутри паутины пеших рёбер поиск мог гулять как угодно. Если её убрать, запрос на глубину в десять рёбер сжимается в 220 раз по медиане. Сама таблица проблемой никогда не была: SQLite строит временный индекс, так что каждый запрос читает её целиком всего дважды. В августе 2026 года пеший переход стал пересадкой — такой же, как смена автобуса. - Логи врали. На следующий день поиск в памяти завис, и ему поставили таймаут в три секунды. Сработать этот таймаут не мог никогда. Чтобы защититься от атак по времени, Workers замораживают часы, пока код работает без всякого ввода-вывода, так что
Date.now()иperformance.now()возвращают одно и то же значение, сколько бы ни крутился цикл. Все «0,00 мс» в наших логах — это и были замёрзшие часы. В августе 2026 года один запрос сжёг 32,5 секунды процессорного времени, прежде чем умер. Теперь поиск останавливается после фиксированного числа шагов, общего на весь запрос. - Ночная джоба появилась через два дня и записывала
navigation-graph1.pb. А Worker читаетnavigation-graph.pb. Так что восемь месяцев, до августа 2026 года, ночная пересборка до прода не доезжала. - Автобусы и правда переехали в Valhalla — в августе 2026 года, с GTFS-фидом, который мы генерируем сами. Об этом — пятая часть серии.
- А тот векторный запрос, на который, по словам первой части, «любая база отвечает моментально»? На него пришлось около 80% всего, что читалось из D1. У таблицы, которую он фильтрует, вообще не было индекса, так что каждый раз, когда приложение его дёргало, она читалась целиком. А поздно вечером он мог даже заявить, что автобусов больше нет: он отбирал шестнадцать ближайших отправлений ещё до того, как разделить их на прошедшие и будущие, и в половине двенадцатого на маршруте, где автобус ходит каждые десять минут, все шестнадцать оказывались в прошлом. С конца сентября 2026 года табло каждого маршрута — это маленький заранее посчитанный файл в Cloudflare KV, который пересобирается при каждом изменении расписания, а запрос читает около двух строк.
- А потом — следующий. Когда табло ушли из D1, в списке самых тяжёлых запросов Cloudflare сменился лидер: поиск остановок, около четырёх миллионов строк в день. Он гонял представление, которое соединяет все остановки, маршруты и рёбра и группирует их, и пересобирал его целиком на каждое нажатие клавиши. Вторым, с 1,25 миллиона, шёл тот самый проверочный запрос на свежесть, который исправление табло только что добавило в каждый запрос табло. В октябре видимая часть сети стала ещё одним файлом в KV, и теперь поиск, ближайшая остановка и карта читают его на чистом JavaScript. Старый SQL остался в тестах — как ответ, с которым новый код обязан совпасть строка в строку.
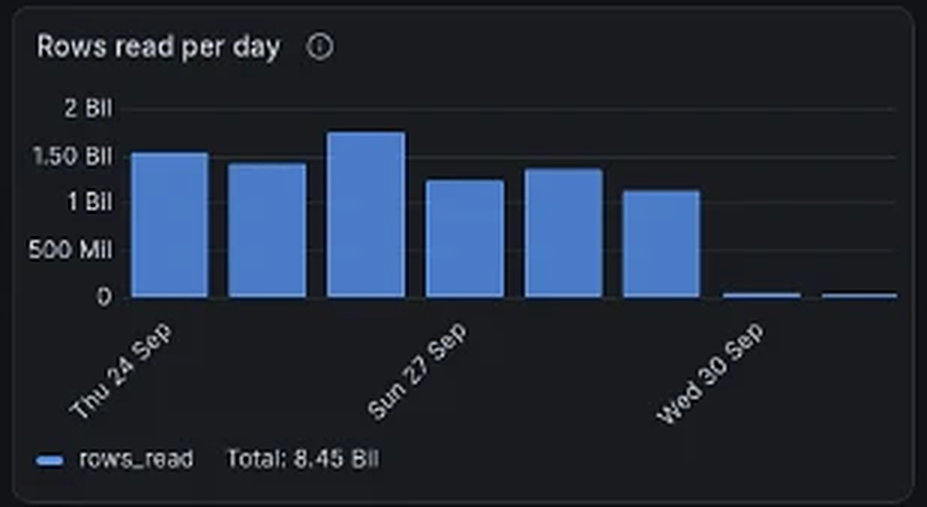
- И дашборд, чтобы за этим следить. Наша Grafana теперь вживую читает из аналитического API Cloudflare те же цифры, что стоят за страницей D1: сколько строк читает каждый запрос — за час и за одно выполнение. Последняя цифра не зависит от трафика и двигается, только когда запрос становится лучше или хуже. Заодно дашборд объяснил, почему запрос ближайшей остановки почти не попадал в рейтинг. Координаты вставлялись прямо в текст SQL — тем самым шаблонным трюком, которым я выше так гордился, — так что каждая точка считалась отдельным запросом. А его первая же неделя наглядно показывает исправление табло: